
Как запускать языковые модели, обрабатывать внутренние документы и автоматизировать работу сотрудников, сохраняя данные внутри собственной инфраструктуры? Один из вариантов — выделенный сервер для искусственного интеллекта. Мы протестировали NVIDIA DGX Spark на реальных задачах, запустили четыре открытые языковые модели и измерили скорость генерации, параллельную нагрузку и производительность AI-агентов.
Результаты показали: DGX Spark не заменяет облачные AI-сервисы по скорости и стоимости обработки токенов. Но для компаний, которым важно контролировать данные и выполнять внутренние задачи в изолированном контуре, такое оборудование может стать практичным решением.
Главный вывод: собственный сервер для корпоративного ИИ нужен не каждой компании. Его основное преимущество — возможность работать с моделями и внутренними данными в контролируемой инфраструктуре, не отправляя запросы во внешние AI API.
Кратко: когда компании нужен собственный сервер для ИИ
Если коротко, выбор между облачным AI API и собственным сервером зависит прежде всего от требований к конфиденциальности, характера задач и количества одновременных запросов.
- Облачный ИИ подходит для массовых запросов, высокой скорости генерации, программирования и задач, где важна минимальная стоимость обработки данных.
- Собственный AI-сервер подходит для обработки внутренних документов, обращений клиентов, персональных данных и автоматизаций, которые должны выполняться внутри контролируемой инфраструктуры.
- NVIDIA DGX Spark — компактная вычислительная система с 128 ГБ объединённой памяти для запуска совместимых локальных моделей и разработки AI-приложений.
- По результатам нашего тестирования одна система обеспечивает примерно 20–30 токенов в секунду и 3–4 параллельных рабочих слота в протестированных конфигурациях.
- Аренда NVIDIA DGX Spark в Support.by стоит 2 150 BYN в месяц за один сервер и 4 500 BYN за два. Для предварительного тестирования доступен Evaluation за 590 BYN в неделю.
Зачем компании собственная инфраструктура для искусственного интеллекта
Сегодня компании используют искусственный интеллект для самых разных задач: автоматизации поддержки, обработки документов, подготовки ответов клиентам, анализа информации, работы с корпоративными базами знаний и создания внутренних помощников.
Большинство таких решений работает через облачные API. Компания отправляет запрос внешнему провайдеру, получает результат и оплачивает использованные вычислительные ресурсы.
Это удобная модель, но у неё есть особенности, которые важно учитывать при внедрении ИИ в бизнес-процессы.
Конфиденциальность корпоративных данных
При использовании внешних AI API запросы и передаваемые данные обрабатываются инфраструктурой стороннего поставщика. Условия хранения, обработки и использования информации зависят от конкретного провайдера и выбранного тарифа.
Для компаний, работающих с персональными данными, договорами, финансовой документацией, внутренней перепиской и коммерческой информацией, это может создавать дополнительные требования к безопасности и соответствию законодательству.
Например, при автоматизации службы поддержки языковая модель может получать обращения клиентов с контактными данными. При обработке документов — договоры, счета и акты. При работе внутреннего помощника — сведения о проектах, сотрудниках и бизнес-процессах.
В таких случаях важно заранее определить, где обрабатывается информация, кто имеет к ней доступ и может ли она покидать инфраструктуру компании.
Контроль над моделями и вычислительной средой
Собственный AI-сервер позволяет самостоятельно выбирать модели, настраивать программное окружение, управлять доступом и определять правила обработки данных.
Это особенно актуально для компаний, которые хотят:
- запускать открытые языковые модели без обращения к внешним API;
- создавать внутренние AI-сервисы для сотрудников;
- обрабатывать документы и обращения по собственным правилам;
- интегрировать ИИ с CRM, ERP, HelpDesk и другими корпоративными системами;
- выполнять регулярные задачи пакетной обработки данных.
Однако собственное оборудование не означает автоматической безопасности. Необходимы настройка сетевого доступа, управление учётными записями, контроль API-токенов и организация мониторинга.
NVIDIA DGX Spark: компактный сервер для локальных AI-моделей
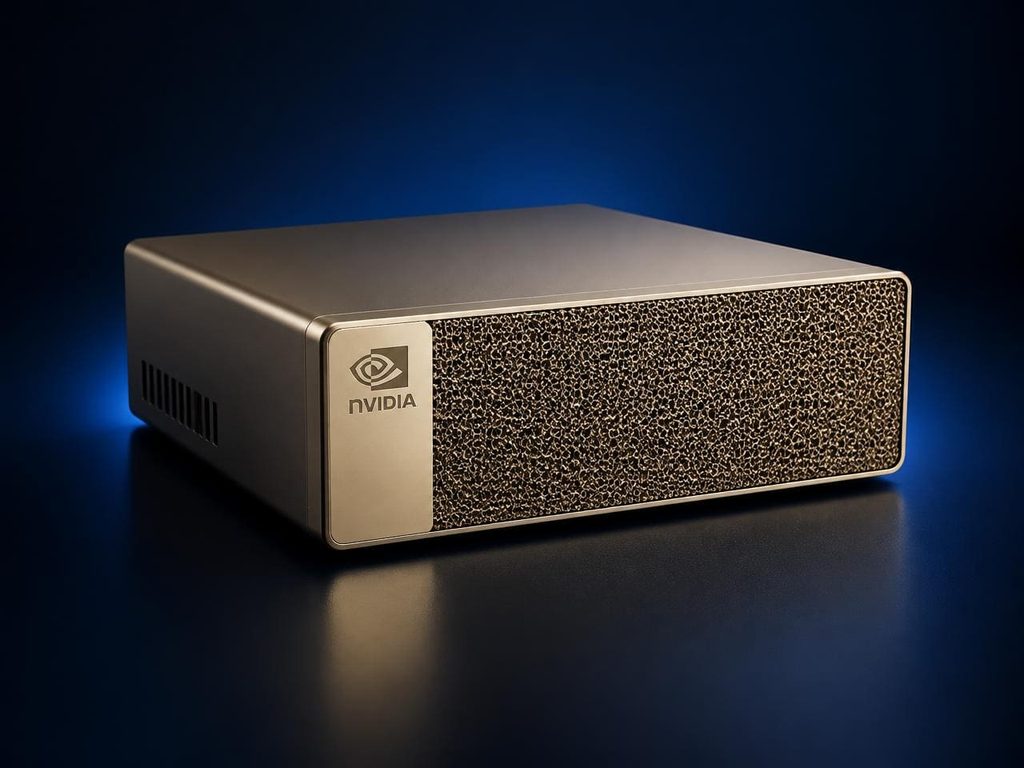
NVIDIA DGX Spark — вычислительная система на базе платформы NVIDIA GB10 Grace Blackwell, предназначенная для разработки, запуска и тестирования моделей искусственного интеллекта.
Её ключевая особенность — 128 ГБ объединённой памяти, доступной CPU и GPU. В отличие от традиционной конфигурации, где память видеокарты и оперативная память системы разделены, здесь используется единое адресное пространство.
Это позволяет размещать в памяти достаточно крупные языковые модели и работать с ними локально, в том числе с использованием квантования.
Основные характеристики NVIDIA DGX Spark
| Характеристика | Значение |
|---|---|
| Вычислительная платформа | NVIDIA GB10 Grace Blackwell |
| Архитектура GPU | NVIDIA Blackwell |
| Процессор | 20-ядерный Arm |
| Объединённая память | 128 ГБ LPDDR5x |
| Пропускная способность памяти | 273 ГБ/с |
| Сетевой адаптер | NVIDIA ConnectX-7 |
| Межузловое соединение | До 200 Гбит/с |
| Управление | Root / SSH |
На нашем стенде операционной системе было доступно около 122 ГБ памяти.
Важно понимать, что 128 ГБ объединённой памяти не означают, что любая модель такого размера автоматически запустится на сервере. Необходимо учитывать размер весов, контекст, рабочие буферы, особенности квантования и требования конкретного программного обеспечения.
Как мы тестировали NVIDIA DGX Spark
Чтобы оценить практические возможности оборудования, мы собрали тестовый стенд на одном NVIDIA DGX Spark.
В качестве программной основы использовали llama.cpp. Проверяли четыре открытые языковые модели в разных вариантах квантования.
Тестирование включало:
- скорость генерации ответа;
- количество одновременных запросов;
- время получения первого токена при длинном контексте;
- работу с контекстом до 128 000 токенов;
- выполнение агентских задач;
- поведение системы при высокой нагрузке на память.
Под скоростью генерации понимается фактическое количество выходных токенов в секунду при выполнении тестовых задач, а не теоретическая пиковая производительность оборудования.
Результаты тестирования моделей
| Модель | Скорость генерации | Параллельные запросы | Первый токен при 128К |
|---|---|---|---|
| Qwen3.8 Flash Next | ≈ 30 ток/с | 4 | 2 мин 46 сек |
| DeepSeek V4 Flash | ≈ 27 ток/с | 4 | 5 мин 55 сек |
| GLM-5.3 Flash | ≈ 24 ток/с | 3 | ≈ 6 мин 25 сек |
| Qwen3.8 27B | ≈ 19 ток/с | 4 | 3 мин 19 сек |
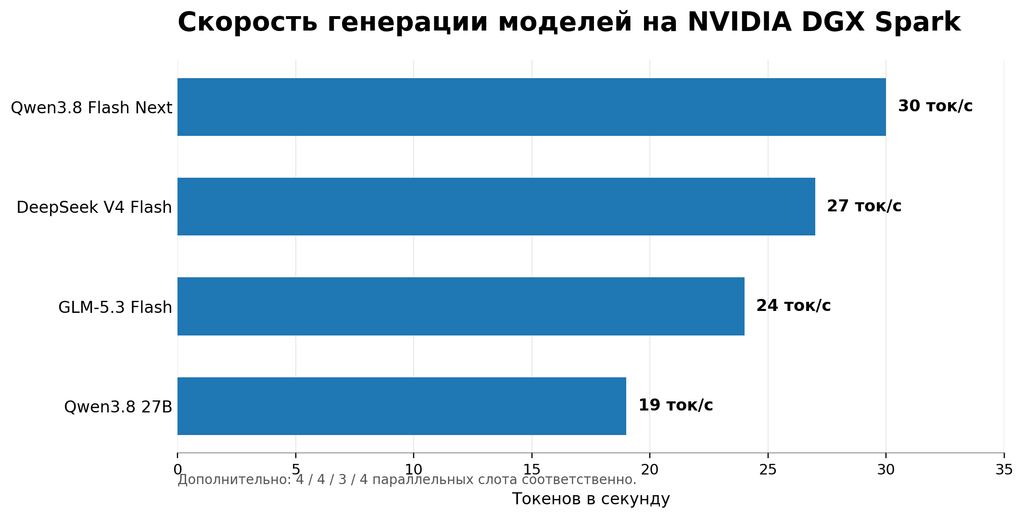
В тестах использовались разные уровни квантования: 4, 2 и 1 бит соответственно. Именно в таких вариантах модели помещались в доступную память стенда.
Лучший результат по скорости показала Qwen3.8 Flash Next — около 30 токенов в секунду при четырёх параллельных запросах.
Эти значения относятся к нашей тестовой конфигурации и не являются универсальным показателем производительности DGX Spark для любых моделей и задач.
Что происходит при увеличении нагрузки
Основное ограничение одного DGX Spark — количество одновременно обслуживаемых запросов.
На стенде мы получили 3–4 параллельных слота для протестированных моделей. При этом в памяти обычно размещается одна средняя модель или несколько небольших.
Технически можно увеличить количество одновременных запросов, но это влияет на скорость генерации. Например, при восьми слотах для Qwen3.8 27B скорость снижается примерно на 40%.
Также необходимо учитывать время обработки длинного контекста. Четыре запроса с контекстом 128К токенов могут проходить очередью за 15–30 минут.
Переключение между моделями занимает около 1–2 минут.
Для агентской задачи «подготовить пять вариантов лендинга» время выполнения составило от 6 до 18 минут в зависимости от используемой модели.
Качество моделей и ограничения квантования
Чтобы разместить крупные модели в доступной памяти, иногда приходится использовать сильное квантование до 1–2 бит. Это позволяет уменьшить объём занимаемой памяти, но может повлиять на качество генерации и точность ответов. В нашем тестировании одна из моделей при сильном сжатии демонстрировала некорректный вывод, поэтому мы исключили её из дальнейших проверок.
Отдельного внимания требует управление памятью. Если система исчерпывает доступные ресурсы, это может привести к зависанию всего процесса. Поэтому на стенде реализован механизм мониторинга, который заранее выгружает модель при достижении критического уровня использования памяти.
Вывод по производительности: DGX Spark подходит для ограниченного числа внутренних пользователей и пакетной обработки данных. Рассматривать один такой сервер как основу публичного AI API для десятков независимых клиентов нецелесообразно.
Собственный AI-сервер или облачный API: что выгоднее?
Один из распространённых вопросов при внедрении ИИ в компании — стоит ли арендовать собственное оборудование или продолжать использовать облачные языковые модели.
Ответ зависит от того, что именно компания оптимизирует: стоимость обработки запросов, скорость генерации или контроль над данными.
Сравнение двух подходов
| Критерий | Облачный AI API | NVIDIA DGX Spark |
|---|---|---|
| Вычислительные ресурсы | Инфраструктура провайдера | Выделенное оборудование |
| Оплата | Обычно за использование | Фиксированная аренда |
| Выбор моделей | По доступности у провайдера | Совместимые локальные модели |
| Контроль над данными | Зависит от условий провайдера | Собственный контролируемый контур |
| Масштабирование | Обычно проще | Требует добавления оборудования |
| Производительность | Зависит от модели и тарифа | Ограничена ресурсами конкретной системы |
| Настройка окружения | Ограничена возможностями API | Root-доступ и собственное ПО |
Сколько стоит обработка токенов в облаке
Для сравнения мы рассчитали примерную стоимость обработки такого же объёма выходных токенов через облачную модель GLM-5.3 Flash.
При полной загрузке одного DGX Spark оптимистичный расчётный предел составляет около 180–300 млн выходных токенов в месяц. Это соответствует суммарной производительности примерно 70–115 токенов в секунду при непрерывной работе. При тарифе $0,50 за миллион выходных токенов аналогичный объём генерации через GLM-5.3 Flash обойдётся примерно в $90–150 в месяц. Для сравнения, стоимость покупки NVIDIA DGX Spark с 128 ГБ памяти по указанной в нашем расчёте цене NVIDIA на октябрь 2026 года составляла $6 950.
Это упрощённое сравнение: оно учитывает стоимость выходных токенов, но не включает входные токены, инфраструктурные расходы и различия в качестве моделей, квантовании, доступности и скорости обработки. Также сравниваются не полностью идентичные условия использования.
Тем не менее результат показателен: если основная задача — генерировать большое количество ответов по минимальной цене, облачный API обычно экономически выгоднее.
Но стоимость токена — не единственный критерий выбора корпоративной AI-инфраструктуры.
Если компания не может передавать определённые данные внешним поставщикам, сравнивать решения только по цене генерации неправильно. В этом случае важны контроль над информацией, архитектура доступа и возможность выполнять обработку в изолированной среде.
Для каких задач корпоративный ИИ на DGX Spark подходит лучше всего
По результатам тестирования мы выделили несколько сценариев, в которых аренда NVIDIA DGX Spark может быть оправдана.
1. Обработка корпоративных документов
Компании регулярно работают с договорами, счетами, актами, коммерческими предложениями и внутренними регламентами.
Локальные языковые модели можно использовать для:
- классификации документов;
- извлечения информации;
- подготовки кратких содержаний;
- поиска ошибок и несоответствий;
- формирования черновиков и структурированных данных.
Например, компания может настроить ночную обработку поступивших документов. Модель последовательно анализирует файлы, извлекает необходимые сведения и передаёт результаты во внутреннюю систему.
Для такого сценария важнее стабильная обработка большого объёма информации к определённому времени, чем мгновенный ответ на каждый запрос.
2. Автоматизация службы поддержки
В корпоративной поддержке ИИ может помогать сотрудникам обрабатывать обращения клиентов и внутренние тикеты.
Возможные задачи:
- классификация обращений по категориям;
- определение приоритетности;
- суммаризация истории переписки;
- подготовка черновиков ответов;
- поиск информации во внутренних инструкциях;
- автоматическая маршрутизация тикетов.
Если обращения содержат персональные данные или коммерческую информацию, использование локальной модели позволяет организовать обработку внутри контролируемой инфраструктуры.
3. Внутренние AI-ассистенты
Собственный сервер можно использовать для создания помощников сотрудников, работающих с корпоративными базами знаний, документами и внутренними системами.
Например, AI-ассистент может помогать специалистам находить информацию в регламентах, готовить отчёты, анализировать документы и выполнять типовые операции.
При этом важно отдельно настроить права доступа: сотрудник должен получать только ту информацию, к которой у него есть разрешение.
4. Внутренние автоматизации и AI-агенты
DGX Spark подходит для разработки и выполнения автоматизаций, в которых несколько операций последовательно выполняются языковой моделью.
Это могут быть:
- подготовка отчётов;
- обработка входящих заявок;
- анализ и структурирование информации;
- формирование документов;
- выполнение задач по расписанию;
- интеграции с CRM, ERP и HelpDesk.
Такие процессы можно организовать через собственный API, используя локальную модель в качестве вычислительного компонента.
5. Собственный приватный API
Компания может развернуть собственный endpoint, совместимый с OpenAI API, и подключить к нему внутренние приложения.
Это позволяет использовать единый интерфейс взаимодействия с моделью, управлять доступом через API-токены и интегрировать ИИ в существующие информационные системы.
На нашем стенде уже реализован OpenAI-совместимый API с токенной авторизацией.
Когда NVIDIA DGX Spark не нужен
Мы считаем важным обозначить и ограничения решения.
Для массового публичного AI-сервиса. Если необходимо одновременно обслуживать десятки и сотни независимых пользователей, одного DGX Spark будет недостаточно. Производительность и количество параллельных запросов ограничены.
Для задач, где важна максимальная скорость. Если пользователям нужны мгновенные ответы, а облачные модели обеспечивают необходимую производительность, переход на локальное оборудование может не дать преимуществ.
Для программирования с помощью ИИ. Специализированные подписки Claude и Codex во многих сценариях удобнее и эффективнее, чем самостоятельный запуск моделей на DGX Spark.
Для проектов без требований к приватности. Если компания может безопасно использовать внешние API, облачная инфраструктура зачастую оказывается выгоднее по стоимости и проще в обслуживании.
Поэтому мы не рассматриваем DGX Spark как универсальную замену облачным AI-платформам. Его задача — обеспечить контролируемую вычислительную среду для определённого класса корпоративных задач.
Как организован AI-контур на стенде Support.by
Мы подготовили не просто сервер с установленной языковой моделью, а рабочую среду для тестирования и дальнейшего использования.
В состав стенда входят:
- OpenAI-совместимый API — подключение внутренних приложений и сервисов по токену.
- Grafana — мониторинг скорости генерации, использования памяти, GPU и дискового пространства.
- Мониторинг памяти — автоматическая выгрузка модели до достижения критического уровня использования ресурсов.
- Профили моделей — возможность быстро переключаться между подготовленными конфигурациями.
- Тестовый набор — проверка холодного запуска, параллельных запросов, длинного контекста и выполнения агентских задач.
Как организован доступ к серверу
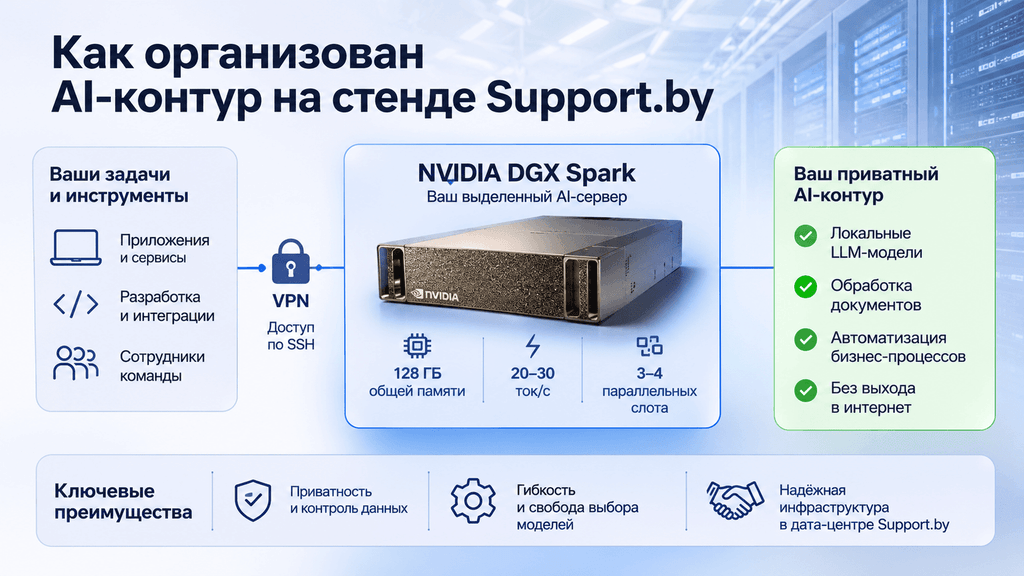
В рамках предлагаемой услуги сервер размещается в дата-центре Support.by в Беларуси.
Управление осуществляется через root/SSH в виртуальной частной сети. Для сервера предусмотрена изолированная сетевая конфигурация без прямого доступа в интернет.
Такая архитектура позволяет ограничить внешние сетевые взаимодействия и организовать работу с моделями внутри контролируемой среды.
При внедрении корпоративного ИИ дополнительно необходимо определить порядок доступа сотрудников, хранения данных, управления ключами и подключения внутренних систем.
Аренда NVIDIA DGX Spark в Support.by
Если вашей компании нужна инфраструктура для запуска локальных языковых моделей, обработки документов и внутренних AI-автоматизаций, в Support.by доступны две конфигурации выделенного оборудования.
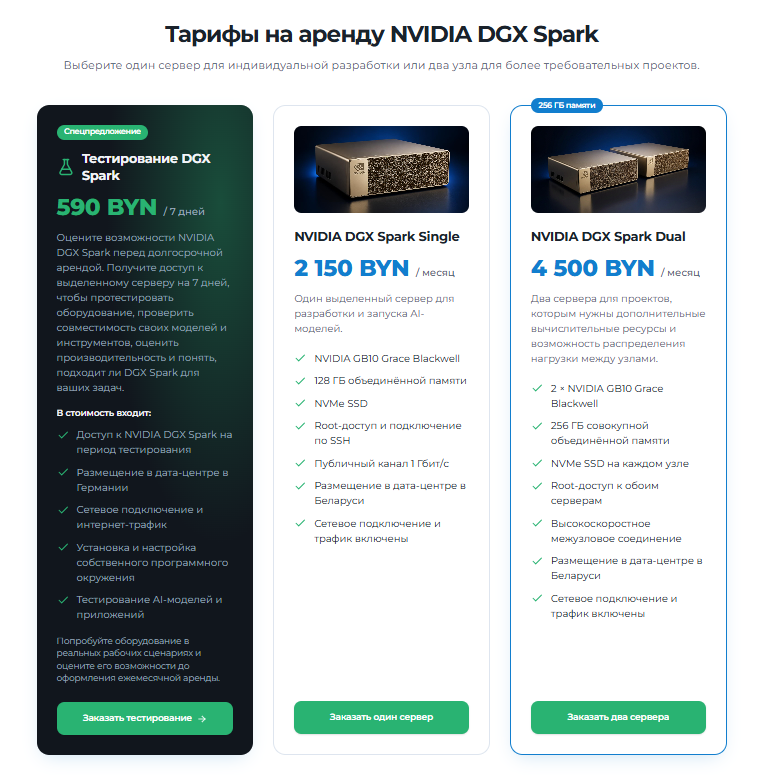
NVIDIA DGX Spark Single
2 150 BYN / месяц
Один выделенный сервер с 128 ГБ объединённой памяти.
Подходит для запуска одной основной модели, разработки AI-приложений, тестирования и выполнения внутренних задач.
- 1 × NVIDIA DGX Spark;
- 128 ГБ объединённой памяти;
- NVMe SSD;
- Root-доступ и SSH;
- VPN-доступ без выхода сервера в интернет;
- размещение в дата-центре Support.by.
NVIDIA DGX Spark Dual
4 500 BYN / месяц
Два выделенных сервера с 256 ГБ совокупной объединённой памяти.
Подходит для задач, которым недостаточно ресурсов одного узла, и сценариев распределения вычислений между системами.
- 2 × NVIDIA DGX Spark;
- 256 ГБ совокупной объединённой памяти;
- NVMe SSD на каждом узле;
- межузловое соединение ConnectX-7 до 200 Гбит/с;
- Root-доступ и SSH;
- VPN-доступ без выхода серверов в интернет;
- размещение в дата-центре Support.by.
Обе конфигурации предоставляются в аренду с выделенным оборудованием. Размещение в дата-центре, сетевое подключение и интернет-трафик включены в стоимость.
Evaluation: протестируйте NVIDIA DGX Spark на своих задачах
Результаты нашего стенда дают представление о возможностях оборудования, но производительность конкретной модели и приложения зависит от используемой конфигурации, программного окружения и характера запросов.
Поэтому перед оформлением ежемесячной аренды можно провести собственное тестирование.
Evaluation — 590 BYN за 7 дней.
За неделю вы сможете:
- проверить работу своих моделей на NVIDIA DGX Spark;
- протестировать обработку собственных данных;
- оценить скорость генерации и параллельную нагрузку;
- проверить совместимость с используемыми инструментами;
- оценить возможности интеграции с внутренними приложениями;
- определить, достаточно ли одного сервера или требуется конфигурация Dual.
По результатам тестирования вы сможете принять решение об аренде оборудования с учётом реальных требований своего проекта.
Часто задаваемые вопросы о собственном сервере для ИИ
Что такое корпоративный AI-контур?
Корпоративный AI-контур — это инфраструктура, в которой языковые модели, приложения и данные используются по установленным компанией правилам доступа и обработки информации. Он может включать собственные серверы, локальные модели, API, базы знаний и интеграции с корпоративными системами.
Зачем компании локальная языковая модель?
Локальная языковая модель позволяет выполнять обработку данных в контролируемой инфраструктуре, управлять программным окружением и не зависеть от внешнего API конкретного поставщика. Такой подход особенно полезен для работы с внутренними документами, персональными данными и конфиденциальной информацией.
Можно ли использовать NVIDIA DGX Spark для корпоративного ИИ?
Да. DGX Spark подходит для запуска совместимых открытых LLM, разработки AI-агентов, обработки документов, внутренних ассистентов и пакетных автоматизаций. Возможности зависят от модели, квантования и нагрузки.
Сколько пользователей может одновременно работать с одним DGX Spark?
В наших тестах одна система обеспечивала 3–4 параллельных слота для проверенных моделей. Это не фиксированный лимит оборудования: фактическая производительность зависит от модели, размера контекста и характера запросов.
Чем локальный ИИ отличается от облачного API?
При использовании облачного API запросы обрабатываются на инфраструктуре внешнего поставщика. При локальном запуске модель размещается на выделенном оборудовании компании или арендованном сервере. Это даёт больше контроля над средой обработки данных, но требует самостоятельной настройки, мониторинга и управления ресурсами.
Можно ли подключить локальную модель к CRM или HelpDesk?
Да. Для этого можно использовать API, через который корпоративные приложения отправляют запросы локальной модели и получают результаты. На стенде Support.by реализован API с совместимым с OpenAI интерфейсом и авторизацией по токену.
Защищены ли данные при использовании DGX Spark?
В предлагаемой конфигурации сервер доступен через VPN, не имеет прямого выхода в интернет и управляется через SSH. Это позволяет ограничить внешние сетевые взаимодействия. Однако безопасность всей системы также зависит от настройки VPN, прав доступа, управления ключами и приложений, подключённых к серверу.
Что выбрать: один или два NVIDIA DGX Spark?
Single с 128 ГБ памяти подходит для большинства сценариев тестирования и работы с одной основной моделью. Dual с 256 ГБ совокупной памяти предназначен для задач, которым требуется больше ресурсов. При этом использование памяти двух узлов как общего пула зависит от программного обеспечения и способа распределения вычислений.
Сколько стоит аренда NVIDIA DGX Spark?
Аренда одного NVIDIA DGX Spark стоит 2 150 BYN в месяц. Два сервера стоят 4 500 BYN в месяц. Для предварительной оценки возможностей оборудования доступен Evaluation за 590 BYN на 7 дней.
Вывод: собственный ИИ нужен там, где важен контроль над данными
NVIDIA DGX Spark не претендует на замену крупных облачных AI-платформ. По стоимости токена, скорости и возможностям масштабирования облачные решения часто выигрывают.
Но у корпоративного ИИ есть другая сторона — требования к конфиденциальности, контролю над данными и независимости от внешних API.
Для таких задач собственная инфраструктура может быть более подходящим решением. Она позволяет запускать локальные модели, автоматизировать внутренние процессы и интегрировать ИИ с корпоративными системами в контролируемой сетевой среде.
В Support.by можно арендовать один или два NVIDIA DGX Spark, а перед долгосрочной арендой — проверить оборудование на собственных задачах в рамках Evaluation.
Если у вас остались вопросы, пожалуйста, свяжитесь с нами.
info@support.by
Понравилась статья? Хочешь получать еще больше полезного контента? Подписывайся на наш блог, будь в курсе последних новостей и интересных материалов из области хостинга и не только!


